
Společnost Xiaomi vstupuje do světa velkých jazykových modelů (LLM) se svým vlastním open-source projektem. Jejich nový model MiMo je prvním velkým AI systémem z dílny Xiaomi, který byl vyvinut specializovaným týmem „Xiaomi Big Model Core Team“.
Přidej se do největší Xiaomi skupiny na Slovensku
Zaměřeno na matematické uvažování a generování kódu
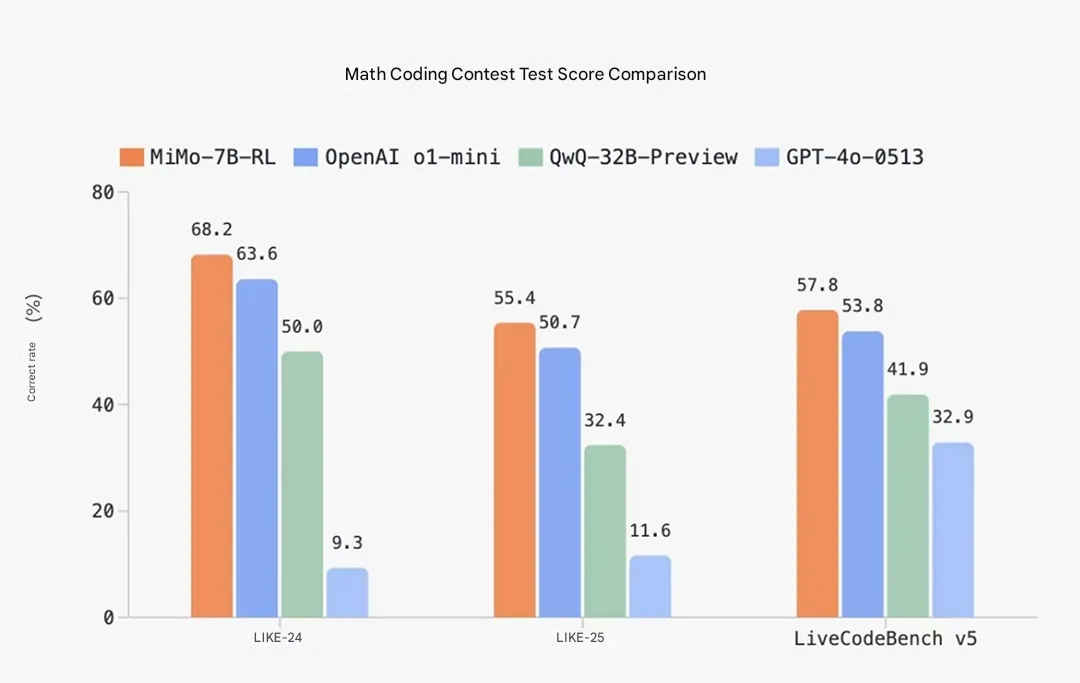
MiMo má velikost 7 miliard parametrů a zaměřuje se na oblasti jako matematické uvažování a generování kódu. Zajímavostí je, že výkonem konkuruje mnohem větším modelům jako OpenAI o1-mini (tvorce ChatGPT) nebo Alibaba Qwen-32B-Preview.
Dosáhnout takové úrovně výpočetní inteligence s „menším“ modelem je výzva, protože většina existujících RL modelů (reinforcement learning) má až 32 miliard parametrů. Xiaomi ale věří, že za úspěchem MiMo stojí kvalitní předtrénovací architektura a následné strategické doladění modelu. Menší velikost MiMo zároveň předurčuje model pro nasazení v podnikových aplikacích nebo na zařízeních s omezeným výkonem.
Jak Xiaomi trénovalo MiMo? Základem je speciální před-trénink
Klíčem k vysokému výkonu modelu MiMo je promyšlený proces předtréninku. Xiaomi optimalizovalo pipeline pro zpracování dat, vylepšilo nástroje pro extrakci textu a implementovalo víceúrovňové filtry, které zvýšily výskyt vzorců logického uvažování v trénovacích datech.

Model byl trénovaný na souboru s více než 200 miliardami tokenů, které reprezentují úlohy z oblasti logiky, matematiky a programování. Xiaomi použilo Multiple-Token Prediction jako tréninkový cíl, což pomohlo nejen zlepšit přesnost, ale také zrychlit inferenci – tedy samotné „přemýšlení“ modelu nad novými úlohami.
Post-trénink: Reinforcement learning s důrazem na přesnost
Po předtrénování následovala fáze doladění pomocí reinforcement learningu. MiMo byl vystaven více než 130 000 matematickým a programovacím úlohám, které byly ověřeny pravidly podle přesnosti a náročnosti. Aby model správně odměňoval výsledky i v komplikovaných situacích, Xiaomi vytvořilo vlastní systém Test Difficulty Driven Reward.
Důležitým krokem bylo nasazení Seamless Rollout Engine, což přineslo 2,29násobné zrychlení tréninku a 1,96násobné zrychlení validace. Tato infrastruktura zároveň podporuje Multiple-Token Prediction a zlepšuje stabilitu modelu při inferenci.
Modelové verze MiMo-7B a jejich využití
Xiaomi vydalo rovnou čtyři verze MiMo-7B, z nichž každá má jiné využití. Jde o:
- MiMo-7B-Base – základní model s vysokým potenciálem pro uvažování
- MiMo-7B-RL-Zero – model s reinforcement learningem trénovaný z verze Base
- MiMo-7B-SFT – model s doladěním pomocí supervised learning
- MiMo-7B-RL – finální RL model z verze SFT, dosahuje srovnatelného výkonu jako OpenAI o1-mini
MiMo dosahuje špičkového výkonu v benchmarkách
Nejpokročilejší verze MiMo-7B-RL dosahuje skvělých výsledků napříč různými standardizovanými testy:
| MiMo-7B-RL | |
|---|---|
| MATH-500 (Pass@1) | 95.8 % |
| AIME 2024 (Pass@1 | avg z 32 možností) | 68.2 % |
| AIME 2025 (Pass@1 | avg z 32 možností) | 55.4 % |
| LiveCodeBench v5 (Pass@1) | 57.8 % |
| LiveCodeBench v6 (Pass@1) | 49.3 % |
| GPQA Diamond | 54.4 % |
| SuperGPQA | 40.5 % |
| DROP (3-shot F1) | 78.7 |
| MMLU-Pro (Exact Match) | 58.6 |
| IF-Eval (Prompt Strict) | 61.0 |
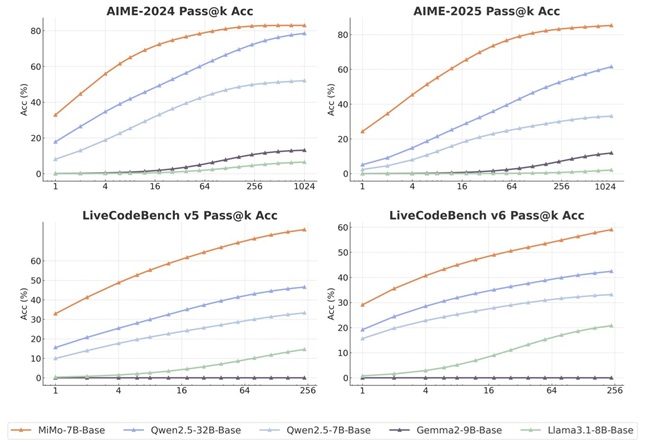
Tato čísla dokazují, že i model střední velikosti dokáže konkurovat mnohem větším řešením, pokud je správně navržený a doladěný.

Dostupnost a open-source přístup
Celá řada MiMo-7B je dostupná jako open-source model na platformě Hugging Face. Xiaomi zároveň zveřejnilo i kompletní technickou zprávu a modelové checkpointy na GitHub, čímž otevřelo dveře vývojářům i výzkumníkům, kteří chtějí stavět vlastní řešení na základech MiMo.
Pro další přísun novinek ze světa Xiaomi sleduj i nadále náš web Xiaomi Planet, přidej se do naší Facebook skupiny, kde tvoříme aktivní komunitu a vzájemně si pomáháme. Odebírej také náš Telegram, kde den co den přidáváme ty nejlepší nabídky a kupóny z Číny.
Nepropásni nejlepší kupóny 📩
Přihlas se k odběru a nové kupóny ti pošleme e-mailem dřív, než vyprší. Posíláme ho jen jednou měsíčně — žádný spam.